你还不清楚 Agent 的概念吗
26 年了,过去几年大模型对编程工作的影响比较明显:从最开始的一问一答,到不止可以生成内容,还可以直接执行任务:读取项目文件、调用工具、运行命令、观察执行结果,并根据执行结果继续行动。像 Claude Code、Codex 等编程 Agent 就是这种形态。
Agent 是什么
可以将 Agent 理解为这几部分的组成:
- LLM:大模型,负责理解需求、推理和决策
- Tool:工具,外部能力的延伸,像读写文件、查询数据库等
- Context:上下文,提供完成任务所需的信息
- Flow Control:流程控制,按照 "执行 -> 观察 -> 再执行" 的方式推进任务
LLM
Large Language Model 的缩写,也就是大语言模型。大多数大语言模型都使用了 Transformer 架构,本是为了改进翻译等序列建模任务。后来发现不仅适合翻译,还特别适合语言理解、文本生成,最终发展为 LLM 这种大模型的核心架构。
从直观角度来看,模型生成文本时,会根据已有内容不断预测下一个可能出现的 token。
Token
Token 是模型读取和生成文本时使用的基本单位。
它不一定是一个汉字或一个单词。文本会先经过 tokenizer 切分成 token,再对 token 进行计算。
Prompt Engineering
最开始的流程是 user prompt -> llm -> assistant response。
但是请求是无状态的,每次请求都是一次独立调用,模型本身不能记住前后的对话。
为了解决这个问题,通常会在每次请求时把历史 messages 一起带入上下文。这样看起来就像模型拥有了对话记忆,但本质上是当前请求里重新提供了历史信息。
除了 user prompt 外还存在 system prompt,可以通过不同的 system prompt 约束 LLM 的角色、语气、边界和输出格式。这就是 Prompt Engineering。
Tools
模型只能根据当前已有的上下文进行推理,但如果问它 "现在几点了",它就不知道了,所以就引入了 tool。
{
  "name": "getTime",
  "description": "Get the current time",
  "execute": () => new Date()
}
模型来判断什么时候调用工具,程序负责执行,并将结果返回给模型。
RAG
Tool 让模型有机会访问外部世界,RAG 则是一类常见的信息获取方式。比如公司的规章制度、奖惩管理等私有数据,不可能都提前写进模型参数里,这就引入了 RAG。
全称是 Retrieval-Augmented Generation,中文一般翻译为“检索增强生成”。
一般都会将私有化信息放到向量数据库中,进行语义化检索。 流程大多数为:
- 将文档切分成较小的内容片段
- 使用
Embedding模型将文本转换成向量 - 将向量保存到向量数据库
- 用户提问时,根据问题检索相似内容
- 将检索结果注入上下文,让模型再生成答案
向量 & 向量化
计算机不能像人一样理解 "吃" 这个文字是什么意思,但擅长比较数字。所以就会先通过 Embedding 模型转换成一组数字。这个将文字转化为数字的过程就叫 向量化。
转换后得到的这组数字就叫 向量。
Agentic RAG
普通 RAG 通常会将检索当成固定流程,但在多轮对话中,当前问题可能依赖之前的上下文。
用户: 我买了个表
用户: 我要退货
如果检索第二句话,可能只得到了通用的退货规则,并不能知道用户想退的是一块表。
这就是普通 RAG 在多轮对话中遇到的问题:检索时没有将历史上下文组织进去
Agentic RAG 的解决思路是:不将 RAG 作为一段固定流程,而是将 RAG 检索作为 Agent 可以调用的工具,这样就可以根据历史对话和当前问题,先改写出更完整的检索问题。
用户: 我买了个表
用户: 我要退货


RAG: 我要退货
Agentic RAG: 买的表如何退货
Context Engineering
Prompt Engineering 解决的是 任务如何说清楚
Context Engineering 解决的是 模型完成任务需要什么
核心就是,在有限的上下文窗口中,准备并组织和当前任务最相关的信息。
- 上下文获取:从历史记录、数据库、文档、工具、用户画像中获取信息
- 上下文选择:判断哪些信息和当前任务有关
- 上下文管理:进行裁剪、摘要、压缩、去重和过滤
- 上下文注入:通过
system messageuser messagetool message或检索结果传给模型
很多时候觉得 "模型降智"、胡编乱造,不一定是模型能力突然变差,也可能是上下文缺失、上下文污染、信息过长或组织方式不合理导致的。
上下文超出的解决方式
- 裁剪和压缩:只保留最近几轮的对话记录 -> 会丢失历史消息
- 摘要压缩:将早期对话总结成一段摘要 -> 会丢失非关键信息
Skills
因为不同业务需要不同的规则,如果把所有规则、流程都写到系统提示词后
- 上下文过大,
Token受不了 - 效率低下
- 模型幻觉
这时候就可以通过 按需加载、动态引入 来解决,也就是所谓的 渐进式披露。
{
  "name": "vue-best-practices",
  "description": "提供 Vue 项目的组件设计和代码规范"
}
有了 name 和 description 后,Agent 就可以先根据描述判断是否需要加载某个 Skill,再按需读取其中更完整的规则、流程和示例。这样既能复用能力,也能避免一开始就把所有信息塞进上下文。
比如:skills.sh
MCP
假设创建了一个获取时间的 Tool,但是只能在当前的 Agent 项目中使用。
如果要在另一个 Agent 中查询时间,还得再重新封装一下。
MCP (Model Context Protocol) 要解决的就是这一类的复用问题。它提供了一套标准化方式,让 Agent 可以连接外部工具、资源和提示模板等能力。
ReAct
ReAct !== react
是 Reasoning and Acting 的缩写,意味着 "推理与行动"。
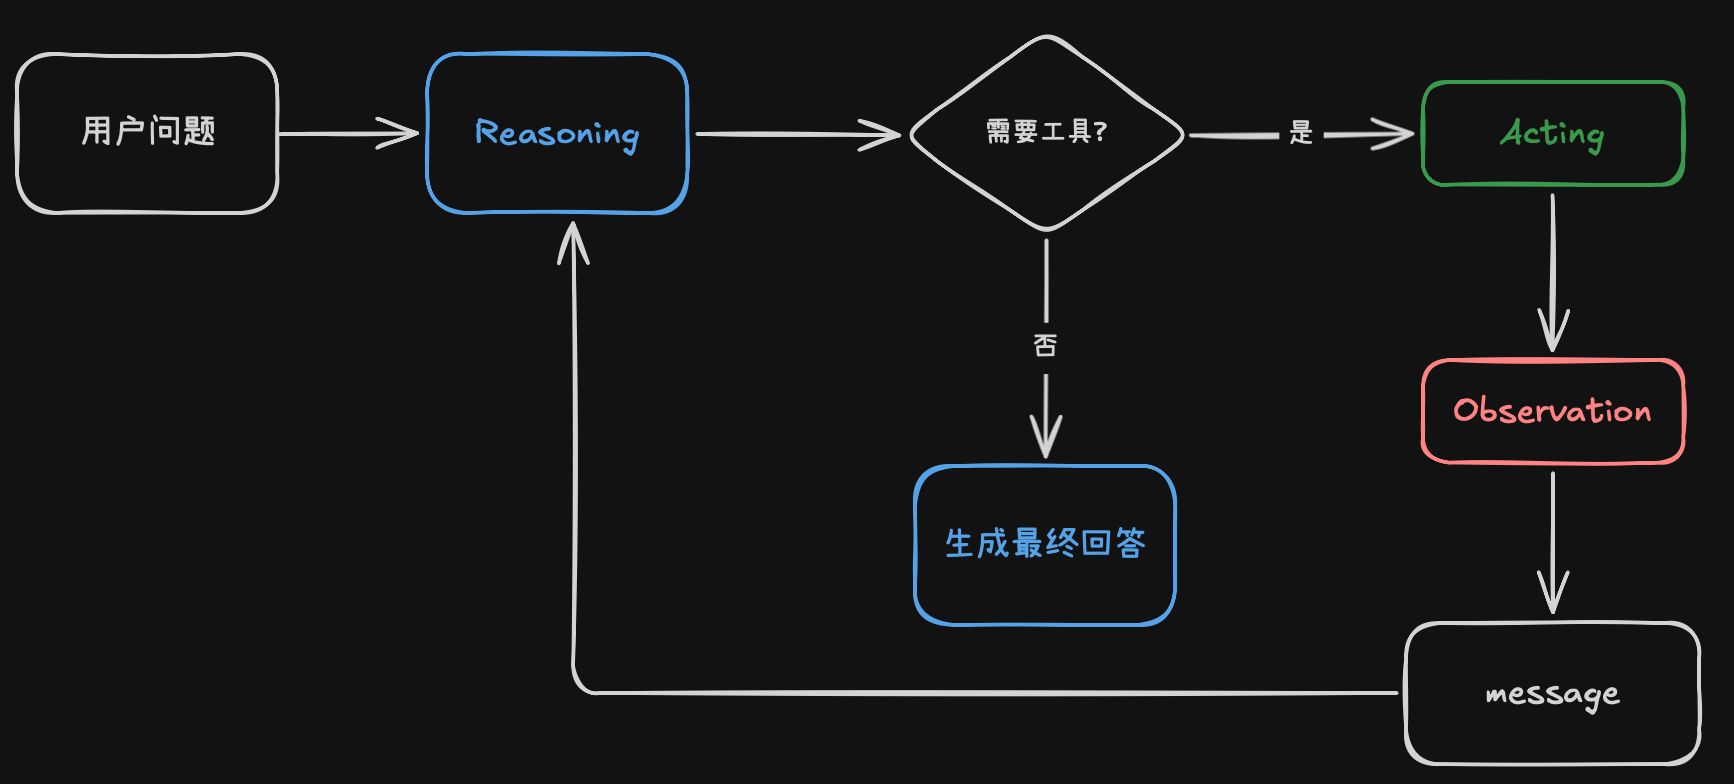
思考:我需要查询当前时间
行动:调用 getTime 工具
观察:得到工具返回的时间
思考:信息已经足够
回答:将结果返回给用户